Selected Work / 2022–2026

做过的东西,
和踩过的坑。

挑了几个能说明问题的项目:打头的是已经上线的智能阅卷平台,后面是知识图谱、影视聚合站、AI 应用与工业中台。每个都写清楚我做了什么、难在哪、最后跑到什么程度。

11 个案例 AI / Java / 物联网 / 交付 南京 · 全国

背景

老师用纸质试卷最耗时的不是判分,是把卷子变成可录、可改、可复用的题目:手写批改要擦干净、整卷要按题号切准、缺页跳号不能吞题。现成工具要么只认固定答题卡,要么整页识别后题框乱飞,拿真实卷子一测就露馅。

方案

Next.js 15 + SQLite 单机可私有化部署。扫描件上传后先按 OCR 方向转正,再做整卷切题(题号断档自检、撞号顺延、跨页双栏去重叠);AI 净卷用 DeepSeek V4.1-Flash 多模态检出手写与批改痕迹,按局部纸色擦除,3×3 分块并行并保护印刷体;一键智能录题直接产出题干、选项、答案与 LaTeX 公式。切题框可缩放、拖动、框选补题,后续接题库组卷、考试管理、答卷评分与成绩统计。

01OCR 方向转正
02题号断档自检
03跨页双栏切题
04AI 净卷擦除
05印刷体保护
06一键智能录题
07切题框编辑
08题库组卷
09自动评分 / 二评

从真实物理试卷里逐轮磨出来的 9 个关键环节

交付

v3.1.0 已上线 yuejian.gaofengtech.cn:录题、题库、组卷、编辑试卷、考试管理、答卷与成绩全链路可用。本地 tsc / next build 通过,线上隔离构建 + 短停机切换,systemd + Nginx 反代,数据库完整性与真浏览器零报错验收。

结果

用真实物理试卷反复回测,修掉漏切题、题号被吞、题框重叠、旋转后坐标漂移、答案留空吞整卷等问题。线上真实试卷验收:智能录题 9.7 秒出 11 题,AI 净卷 20.9 秒擦除 47 处手写痕迹。复用已有服务器与证书,无新增资源采购,可整包复制到学校私有化部署。
背景

初三复习最大的问题不是没资料,是资料散:化学、物理、数学三科,不同地区用不同教材,知识点前后关联又跨章节。想做一个能在手机、平板上直接用的复习站,学生各看各的进度,不互相干扰。

我做了什么

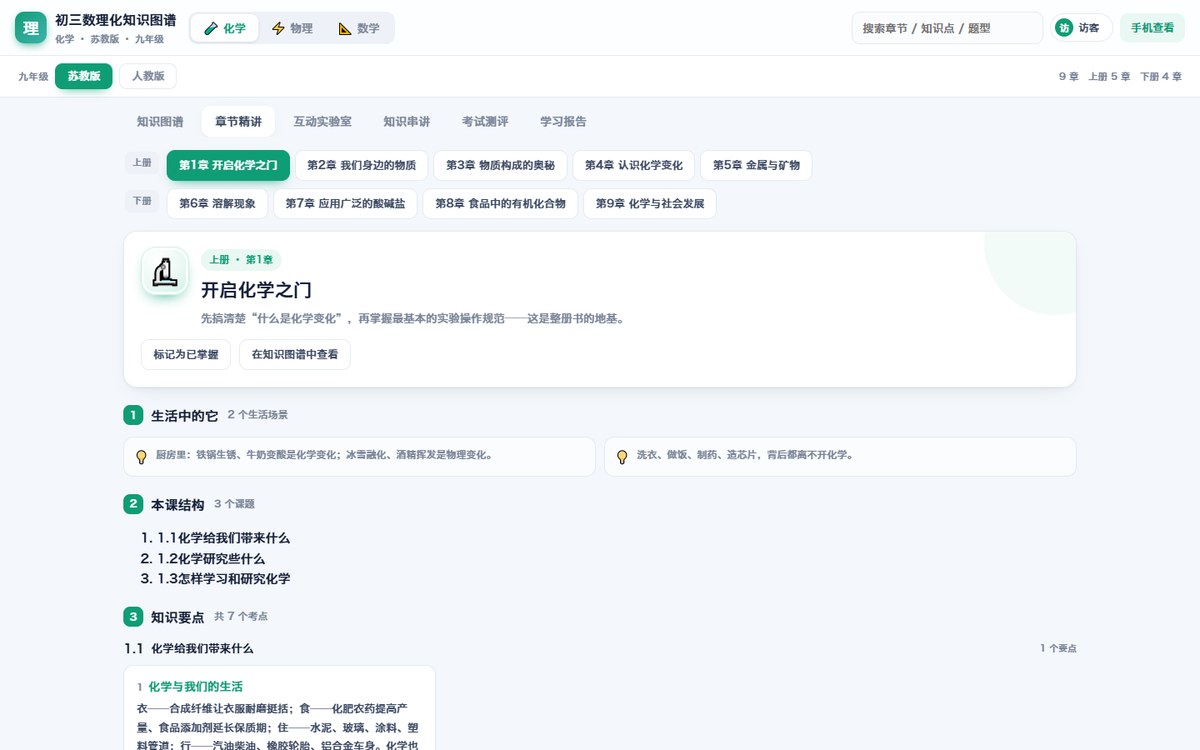
  • 内容结构:整理 6 个教材版本(化学苏教/人教、物理人教/苏科、数学苏科/人教),共 56 章、206 个课题、331 个知识点、147 类题型。
  • 题库:297 道章节训练题、56 份章节测试、300 道跨章考试题,每题标注对应知识点,用于薄弱点加权组卷。
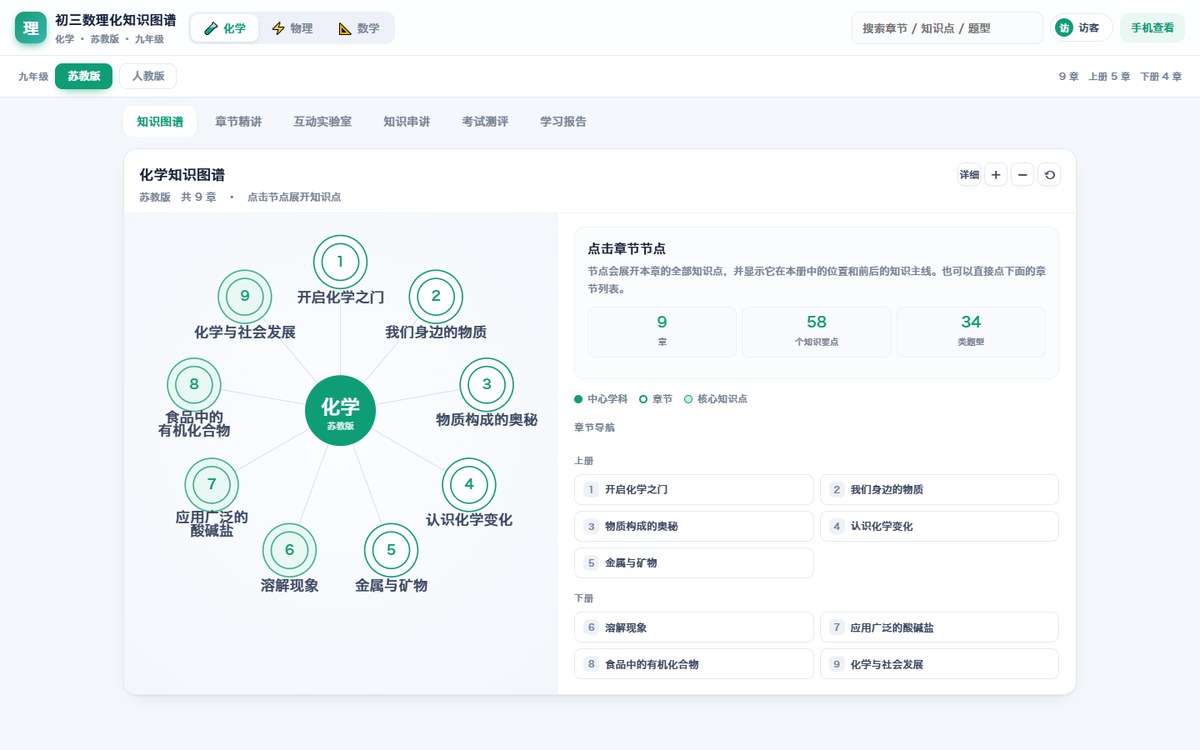
  • 前端:无框架原生 JS + SVG。知识图谱可拖拽缩放,章节居中展开知识点,虚线连前后知识主线与跨章关联;14 个互动实验台也是 SVG 绘制。
  • 后端:Python ThreadingHTTPServer 子类 + SQLite 两张表。多用户各自 PIN 登录,保存掌握进度、错题本、收藏、考试记录。
  • 批改:选择题即时判;填空兼容全角半角、上下标、空格;简答按采分点给分;判错可申诉修正并从错题本移除。
  • 部署:Nginx 反代本机 8090,systemd 托管开机自启,Let's Encrypt 证书,独立二级域名。

难在哪

1. 内容比代码重。6 个版本的章节顺序、课题划分、知识点命名都不一样,直接合并会串版本。做法是每个版本独立章节树,知识点做统一 ID,跨版本用映射表关联,换教材时正在做的卷子自动作废。

2. 一个文件的后端也要扛多人。用 ThreadingHTTPServer 而不是单线程 HTTPServer,SQLite 开 WAL,写操作串行化,避免两个学生同时提交时锁库。

3. 手机上的图谱。SVG 在窄屏容易糊成一团,最后按容器尺寸动态算半径和字号,触摸拖动 + 双指缩放,节点点击区域单独放大。

结果

已上线 xuexi.gaofengtech.cn,手机、平板、电脑直接打开,无需安装。从内容整理、前端交互、后端存储到域名、证书、进程守护,一个人收尾。

初三数理化知识图谱首页与知识图谱 初三数理化知识图谱章节精讲页面

先说清楚

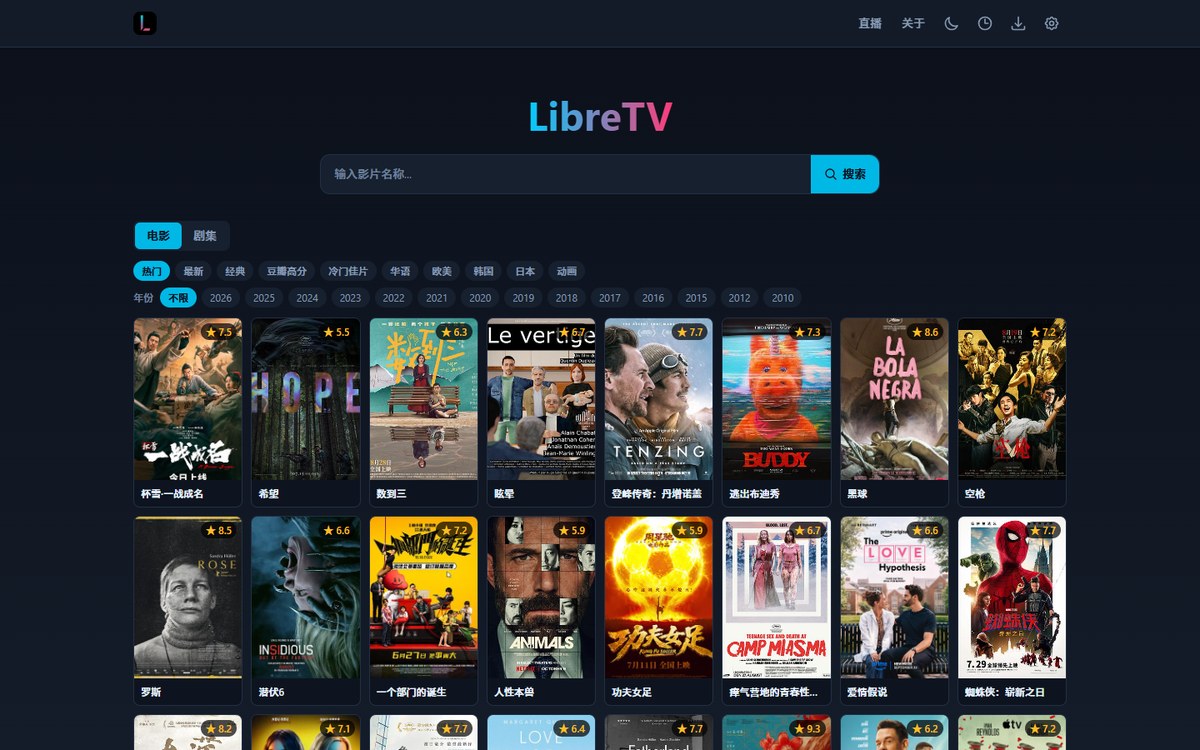
这不是我从零开发的项目。LibreTV 是开源项目(AGPL-3.0),我做的是在自己的服务器上把它跑稳:部署、反向代理、HTTPS、进程守护、访问控制、移动端可用性和日常排障。

我做了什么

  • 部署:Ubuntu 22.04 + Node 22,Next.js 生产构建,systemd 托管(libretv 服务,用户 www,开机自启)。
  • 网络:应用只监听 127.0.0.1:8081,不直接暴露公网;Nginx 反代 + Let's Encrypt 证书 + HTTP→HTTPS 跳转 + HSTS。
  • 访问控制:站点级密码访问,会话密钥由环境变量派生;代理接口加签名密钥,避免被外部直接调用。
  • 功能验证:聚合搜索、详情、豆瓣榜单、HLS 播放、直播 / IPTV、PWA 安装、亮暗主题,逐项在桌面和手机上过一遍。
  • 运维:日志分离(应用日志 / Nginx 日志)、内存占用监控、证书自动续期、异常重启策略。

踩过的坑

1. 宝塔的 vhost 冲突。面板自动生成的站点配置里已经有 server_name,再手写一个同名 vhost,Nginx 会报 conflicting server name 并忽略后加载的那个,结果 HTTP 和 HTTPS 走进不同站点。最后改成在面板站点的扩展配置里加反代。

2. HTTPS 下的登录态。反代后应用看到的是 HTTP,Cookie 的 Secure 判断会出错。要么显式配置,要么让 Nginx 传对协议头,否则登录成功但下一次请求又掉回密码页。

3. 移动端播放。HLS 在部分手机浏览器上不能自动起播,需要用户手势触发;播放器尺寸和竖屏安全区也要单独调。

结果

已上线 tv.gaofengtech.cn(私有站点,需密码)。从空白服务器到 HTTPS 可访问、手机可用、重启自恢复,整个过程和排障记录都整理成了部署文档。

LibreTV 影视聚合站首页
deploy.checklist
01Next.js 生产构建node 22
02systemd 托管自启 / 重启
03Nginx 反代127.0.0.1:8081
04Let's Encrypt自动续期
05密码 / 签名访问控制
06手机 / PWA实测通过

背景

四五线乡镇的通知,长期靠大喇叭和微信群:覆盖不全、发完不知道谁收到、出事没有记录。老人不会用智能机,在外子女不知道父母能领什么政策,政府买了服务也缺过程数据。村讯通想做的不是又一个 App,而是把村委、村民、家属、政府放在同一套「人-户-事」数据上。

方案:一个底座,三个场景

01智能通知 · 入口 / 获客
02养老照护 · 付费
03本地帮办 · 留存
04村民不装 App,接电话按键
05村委小程序选人、录音、一键发
06未接自动重呼 + 短信兜底

村民接电话按 1 确认、按 2 求助、按 9 退订;村委在手机上选人、录一段方言,系统自动外呼并回一张表:谁接了、谁没接、谁要帮忙。底层是村、户、人、事四张主表,通知、照护、帮办共用一套通讯录。

我做了什么

  • 产品与商业:一套 15 份分册 + 附录模板,覆盖定位、用户、竞品、数据底座、通知、养老、帮办、路线图、财务测算、合规、组织、BP、试点手册、技术架构、冷启动与增长。
  • 数据底座:村 / 户 / 人 / 事四张主表,20 列最小字段集;标签、同意记录、触达记录;区县 → 乡镇 → 村 → 户 → 人五级租户与数据权限。
  • 通知闭环:任务 → 名单 / 同意校验 → 外呼 → 按键回调 → 未接重呼 → 短信兜底 → 回执台账;幂等键、并发限流、回调验签、超时补偿。
  • 养老与帮办:政策规则库、护理视频、紧急呼叫转接;黄页、送餐、维修、代办、团购、派单与结算。
  • 试点与交付:30 / 60 / 90 天执行手册,选点评分、首访话术、异议处理、验收指标;12 周 MVP 开发计划与接口清单。
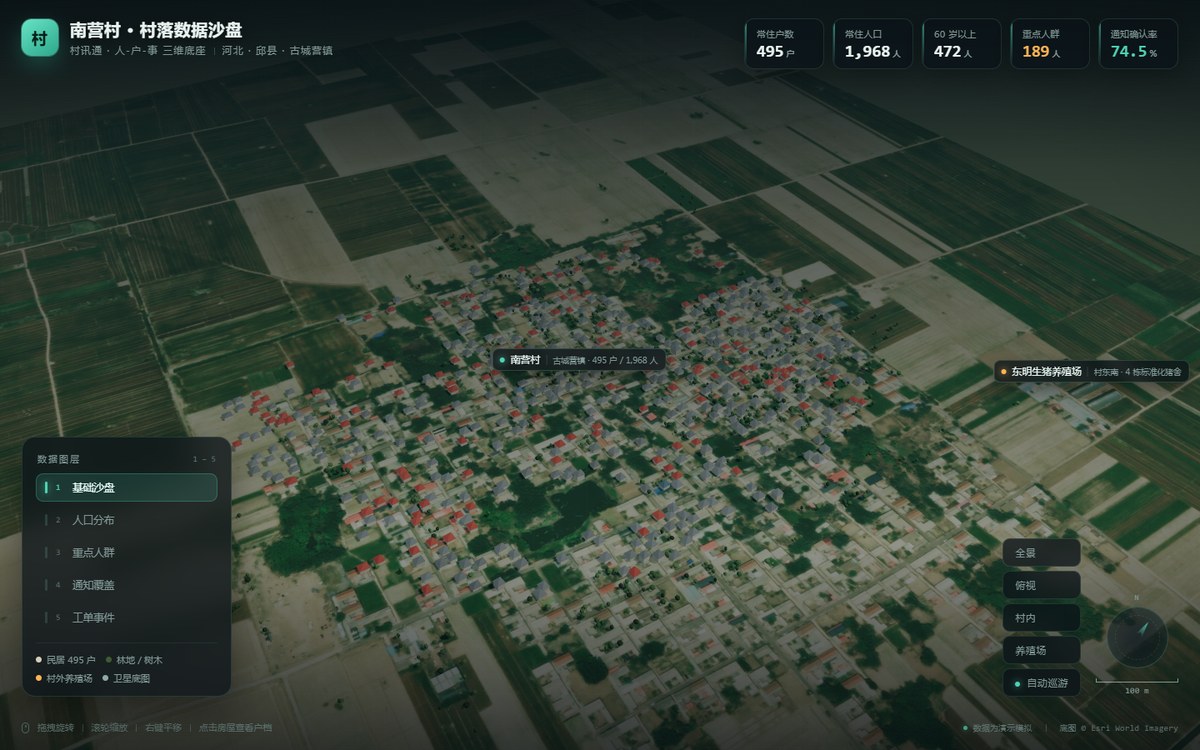
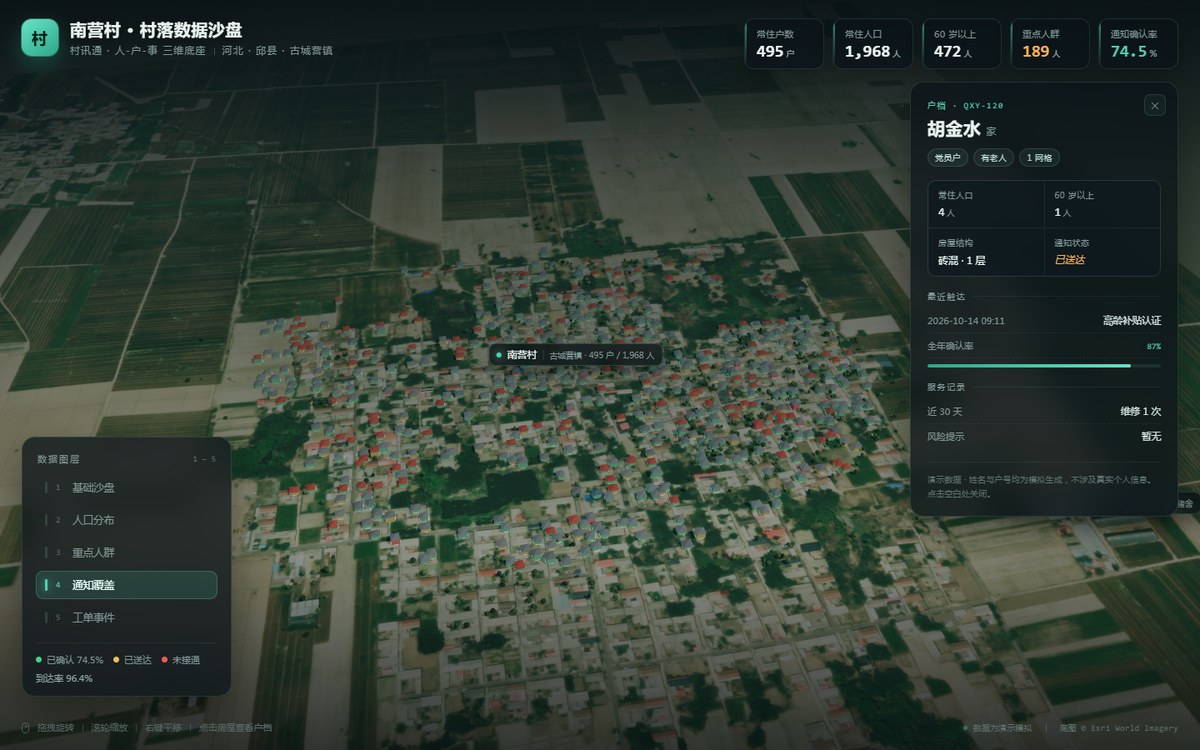
  • 3D 数据沙盘:以河北邱县南营村为样本,495 户 / 1,968 人 / 472 位 60 岁以上 / 189 位重点人群;495 栋民居 + 568 棵树,5 个数据图层,点击房屋查看户档。

为什么先做 3D 沙盘

这类产品最难讲清的不是功能,是「数据到底长什么样」。用 Three.js 把真实卫星影像、房屋点位、人口和通知状态叠在一个村里,村委能一眼看懂,投资人和政府也能判断数据底座是不是真的能落地。沙盘用 InstancedMesh 渲染 495 栋民居和 568 棵树,单场景约 20 个 draw call;户档、通知、工单均为演示模拟,不涉及真实个人信息。

商业模型

单村 1,500 元 / 年(含 6,000 分钟外呼),乡镇 1.8 万 / 年(10 村起),政府购买服务 8–30 万 / 项目,家庭订阅 99 元 / 年,本地商家 300–600 元 / 年 + 8% 抽佣。按 100 个村 / 6 个乡镇测算,第 3 年基本打平;启动资金 60–80 万,可支撑 18 个月。

状态

目前交付的是完整落地方案 + 可交互 3D 沙盘原型,还没有真实村庄上线。下一步按 30 / 60 / 90 天手册跑 1 个主村 + 2 个复制村,用到达率 ≥ 95%、确认率 ≥ 70%、数据完整率 ≥ 80% 决定是否继续。这个项目最值钱的不是代码,是一村一录的数据脏活和村委信任。

南营村 3D 村落数据沙盘 村讯通户档与通知覆盖图层

底图 © Esri World Imagery;户档、通知与工单为演示模拟数据,不涉及真实个人信息。

背景

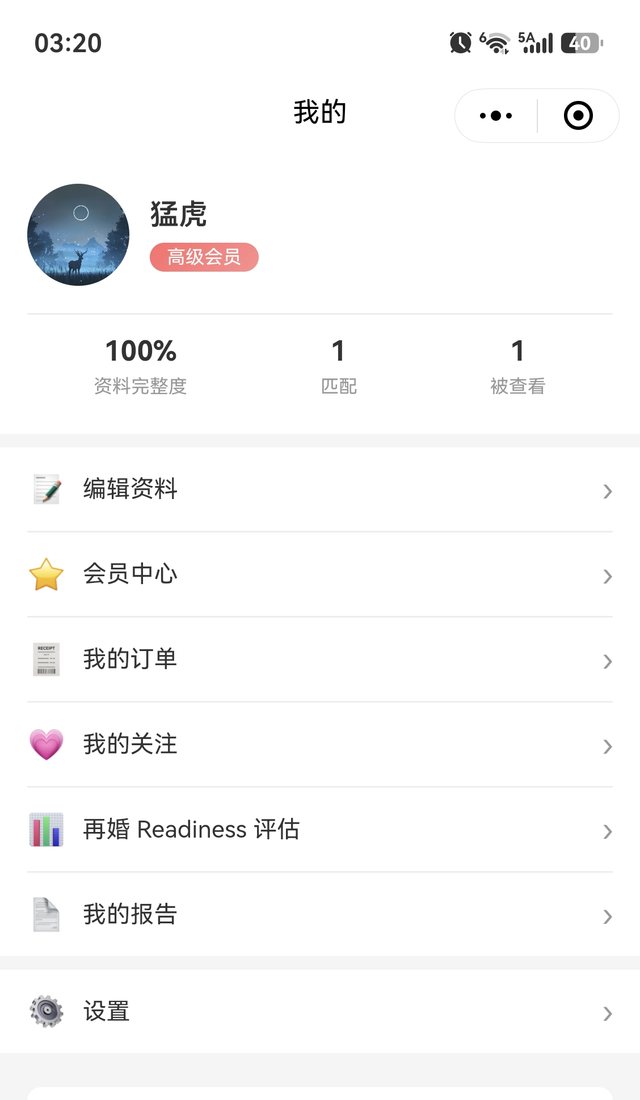
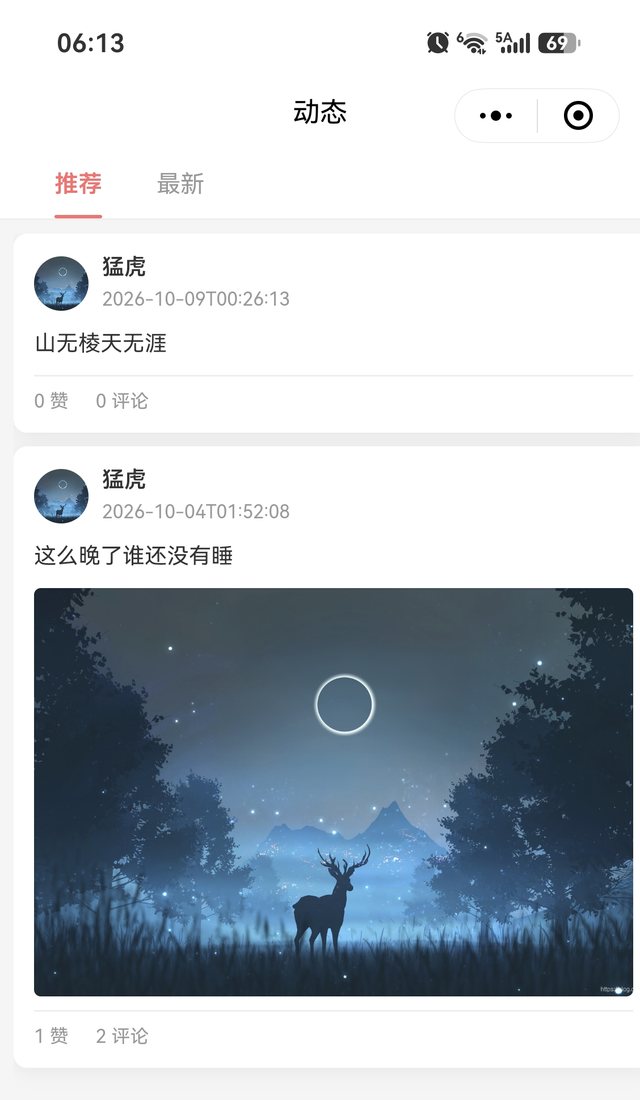
再婚人群做决策时,信息散、顾虑多、缺少结构化的判断工具。再启不是交友平台,而是「决策引擎」:推荐匹配 + 五维分析 + AI 决策报告 + 动态社区 + 实时聊天。先做南京单城,靠公众号内容引流,小程序承接。

我做了什么

  • 后端:Spring Boot 3 + MyBatis-Plus + MySQL + Redis;推荐、匹配、报告、动态、聊天、会员、订单、后台管理。
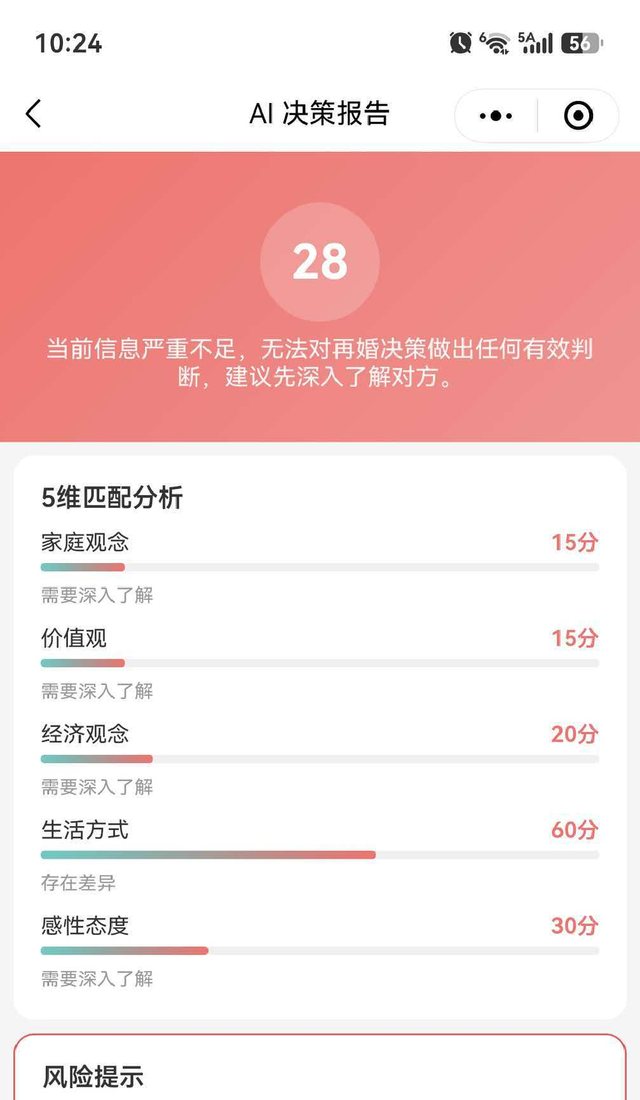
  • AI 接入:DeepSeek API 生成五维匹配分析、完整决策报告、Readiness 评估、聊天建议;统一 System Prompt + JSON 输出。
  • 小程序:uni-app / Vue 3 编译微信小程序;H5 与管理后台复用同一套接口。
  • 支付与合规:微信虚拟支付回调、内容安全 msgSecCheck / mediaCheckAsync、隐私保护指引、UGC 服务端开关。
  • 部署:Nginx + Let's Encrypt + systemd;api.gaofengtech.cn 上线,完成 ICP 备案与小程序合法域名配置。

几个真实的技术难点

1. 模型输出不能直接信。LLM 返回的 JSON 偶尔带解释文字或字段缺失。做法是统一 Prompt、服务端解析后校验结构,解析失败自动降级到兜底数据——AI 挂了,主流程不能挂。

2. 微信消息推送只能配一个 URL。支付回调和内容审核结果都走这个入口。服务端按事件类型分流,避免两套逻辑互相覆盖。

3. 审核期不能发 UGC。用 Redis 做服务端功能开关,审核期关闭发帖/评论/发消息,审核通过后改 Redis 即可放开,不需要重新发版。

4. 个人主体的类目限制。经历 3 轮提审:隐私授权时机、UGC 类目、动态 tab。最后按平台规则收敛功能,先保证能上线。

结果

1 人完成全栈;完成 3 轮提审迭代与功能收敛;后端、数据库、支付、内容安全、备案全部自己收尾。

再启 AI 决策报告页面 再启个人中心页面 再启动态社区页面

背景

做内容最耗时的不是「想」,是重复劳动:做图、配音、对字幕、合成、上传、填标题。目标是把一条知识类短视频从选题到发布,压到 10 分钟以内,并且能稳定重复。

流水线

  • 01选题 / 文案按方向随机选题,生成叙事化口播文案与卡片结构
  • 02图文卡片Pillow 生成科技感图文卡;支持实景图、渐变、强调色
  • 03配音 / 字幕Edge-TTS 男/女声随机,按句生成音频与 SRT 时间轴
  • 04视频合成ffmpeg 分段、拼接、压字幕、混音;避开中文路径与滤镜兼容坑
  • 05自动发布Playwright 连接真实 Chrome + CDP,穿透 closed shadow DOM 完成点击
  • 06结果校验以发布成功后的 URL 跳转为信号,避免「看起来点了,其实没发出去」

最难的部分:自动发布

小红书把发布按钮放在 closed shadow root 里,页面内 JS 拿不到节点。Playwright 自带的隔离浏览器还会被识别,页面直接降级、按钮不渲染。最后方案是:连接真实 Chrome 的调试端口,用 CDP 的 DOM.getDocument(pierce:true) 穿透 shadow root,再用 DOM.getBoxModel 实时取坐标,真实鼠标点击。

中间还踩了 Chrome 单实例、调试端口被吞、进程生命周期被父进程杀掉、坐标随视口变化等坑。每一个都写进了项目交接文档,避免下次重踩。

结果

图文、配音、字幕、合成、发布全链路跑通;单条视频 10 分钟内出片;小红书首次成功发布,抖音同步产出。这套东西后来也成了接「AI 视频代运营」的交付底座。

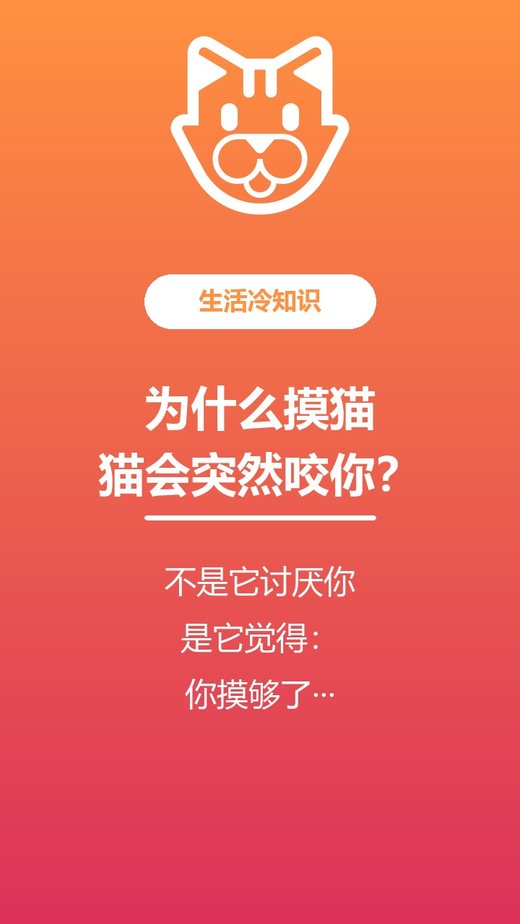
AI 生成的图文卡片示例
publish_clean.js
// 连接真实 Chrome,而不是隔离浏览器 const browser = await chromium.connectOverCDP( 'http://127.0.0.1:9222' ); const doc = await client.send( 'DOM.getDocument', { depth: -1, pierce: true } ); // 找到发布按钮 → 取实时坐标 → 真点击 await page.mouse.click(x, y);

背景

轨道交通检修需要机器人对车辆关键部件做视觉检测。机器人本体有自己的 3D 视觉、多模态感知、SLAM 导航、力位混合控制;中控平台要负责「谁去、去哪、做什么、做到哪、出问题怎么办」。

系统做什么

  • 机器人管理与控制、巡检任务编辑、智能调度、作业实时监控、数据采集存储、告警、大屏展示。
  • 与充电桩、升降平台等智能设备交互;与算法组(视觉、导航)协同,调度多机器人越障跨轨作业。
  • Spring Cloud 微服务 + Kafka + Redis + Nacos + Sentinel + Netty;MQTT / Modbus / RTSP 设备接入。
  • 熔断、降级、限流,防止单点故障拖垮现场;Docker 容器化部署。

现场

项目与国铁、中车集团合作,推广到全国多省市轨交运维现场。我承担现场联调、部署、客户培训与问题闭环——不是交付一个包就走,是要保证现场能用、敢用。

SYSTEM MAP / ROBOT OPS
调度中台Spring Cloud
机器人本体
3D 视觉
充电桩
升降平台
SLAM 导航
远程监控

结果

国铁、中车多省市落地;现场安全零事故;形成一套可复制的设备接入、任务调度与现场交付方法。

背景

银发人群的健康管理有两个特点:操作要极简,子女要能远程参与。项目定位不是「AI 看病」,而是「AI 中医健康管家」:体质辨识、养生内容、用药提醒、亲情联动。

做了什么

  • 适老化 MVP:大字、高对比、核心操作不超过 2 步;舌象采集 → 体质报告 → 调理建议。
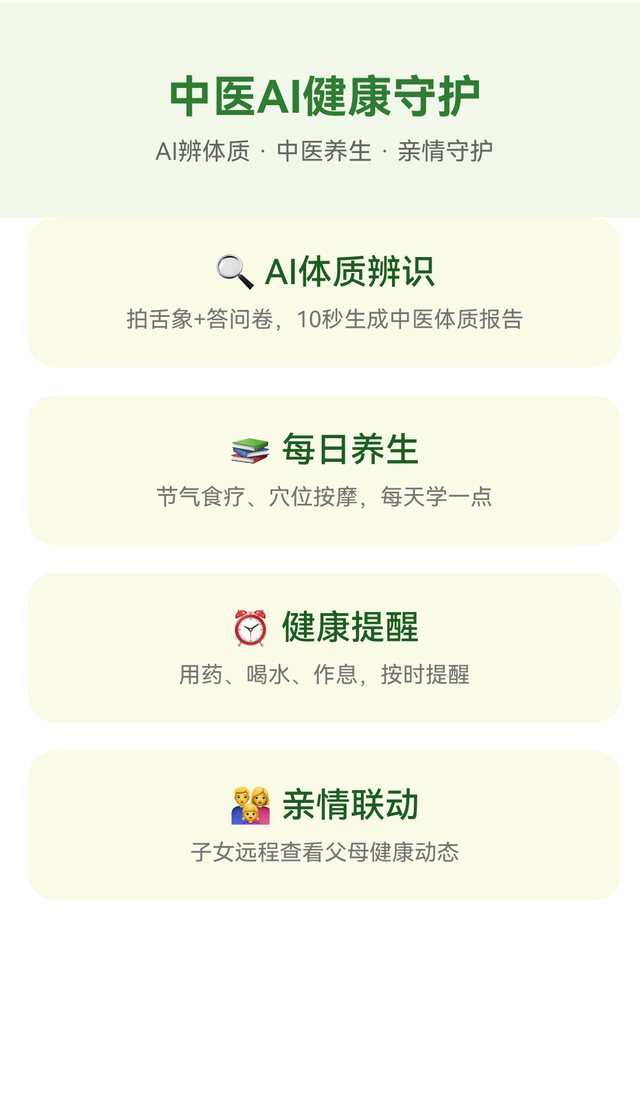
  • 功能:AI 体质辨识、每日养生、用药/喝水提醒、子女远程查看父母健康动态。
  • 技术方案:ArkTS / ArkUI-X 一套代码多端;华为 AGC 云函数 + 云数据库 + 云存储,初期零运维、低成本。
  • 输出可落地实施方案:功能优先级、技术架构、成本估算、合规清单、实施路线图。

先想清楚合规

医疗健康是强监管领域,个人开发者尤其不能碰红线。方案里明确三条:不做在线问诊、不做 AI 诊断、不销售药品/中药饮片。所有输出标注「健康管理参考,非诊断工具,不替代医生」。

上架路径也按「单机工具 → 云服务 → 会员」分阶段,先验证,再加深。

结果

完成可运行的鸿蒙 MVP 原型与完整实施方案;把「能做」和「不能做」的边界写在前面,避免做完才发现上不了架。

中医 AI 健康守护鸿蒙应用首页
compliance.md
×在线问诊 / 首诊不做
×AI 诊断 / 开方不做
×销售药品 / 饮片不做
✓健康管理 / 养生参考可做
✓适老化 / 亲情联动可做
本应用提供健康管理参考, 不构成诊断结论,不替代医生诊疗。 如有不适,请及时就医。

背景

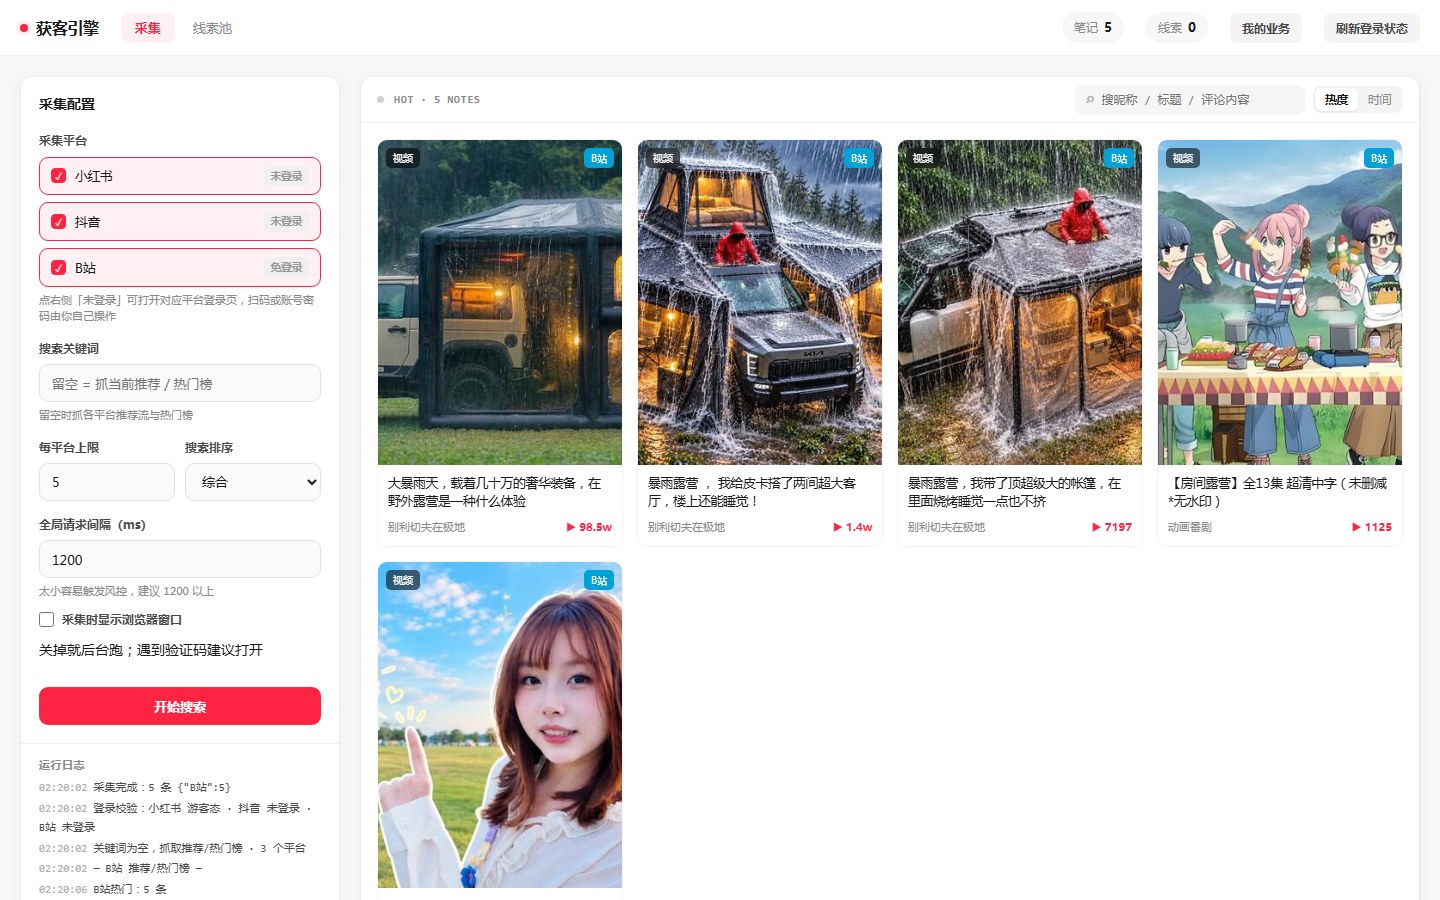
做内容运营最花时间的不是创作,是「找选题、翻评论、追客户」:一个关键词要在小红书、抖音、B 站各搜一遍,把笔记链接、作者、点赞、评论一条条抄进表格,再挨个回评论、发私信。想把这套动作收进一个后台——搜一次,三个平台的笔记和线索一起出来。

系统做什么

  • 采集:关键词留空即抓当前热榜 / 推荐流,填了就走平台搜索。按平台设上限、设全局请求间隔、综合 / 热度 / 时间排序,避免触发风控。
  • 克隆改写:一键把原笔记的文案、图片、视频一起带出来,在弹窗里改标题正文、换图、删减素材,改完直接发布,不用跳回平台发布页。
  • 线索池:评论按笔记聚合,带评论时间、作者、原文;支持行选中、话术模板评论与回复。
  • 登录态:各平台扫码或账密登录,登录态落在独立 Chrome profile 里持久化,重启不丢。
  • 可观测:采集进度用 SSE 把日志实时推到前端,不用轮询猜状态。

难在哪

1. 扫码登录的 3 秒窗口。小红书扫码后手机上还要确认,页面在这几秒里会刷新,登录态没落盘就被冲掉,表现就是「登录成功但显示未登录」。改成登录动作独立进程、profile 目录独占、确认完成后再读 Cookie,才稳定下来。

2. 抖音搜索的验证码。搜索词触发人机验证时页面结构会变,硬等元素只会一路超时。现在识别到验证码就明确报错,并提示打开可视化浏览器人工过一次,而不是假装采集成功。

3. 反代把 SSE 吞了。宝塔模板里有 location ~ .*\.(js|css)?$,正则优先于前缀匹配,/app.js 被它截去站点根目录找静态文件,直接 404。反代必须写 location ^~ / 跳过正则;再加 proxy_buffering off,否则日志要等请求结束才一次性吐出来。

4. Chromium 跨用户读不到。Playwright 默认装到 /root/.cache,服务却以 www 用户跑,启动就报找不到浏览器。挪到 /opt/ms-playwright 并 chmod -R a+rX 才解决。

5. 服务起不来的 203/EXEC。模板里写死 /usr/bin/node,这台机器实际装在 /usr/local/bin。改成安装时用 command -v node 探测再替换,换机器不用改文件。

结果

已上线 hkx.gaofengtech.cn。服务器端真实采集验证通过:B 站关键词一次返回 5 条笔记、0 报错。代码私有托管,部署脚本、systemd 单元、Nginx 配置和排障文档都在仓库里。

获客引擎采集界面:平台配置、检索结果与运行日志
collect.pipeline
01关键词 / 热榜小红书 · 抖音 · B站
02真实浏览器采集Playwright
03SSE 实时回传不轮询
04克隆 / 改写图文 + 视频
05弹窗内直接发布不跳平台
06线索池 / 评论回复话术模板

先说清楚

内核是开源的 MoneyPrinterTurbo,我做的是把它从「本机能跑」变成「服务器上能给别人用」:路径改造、依赖补齐、资源迁移、进程守护、反代和排障。它正好补上我前面那条自动发布流水线缺的一块——批量出片。

它做什么

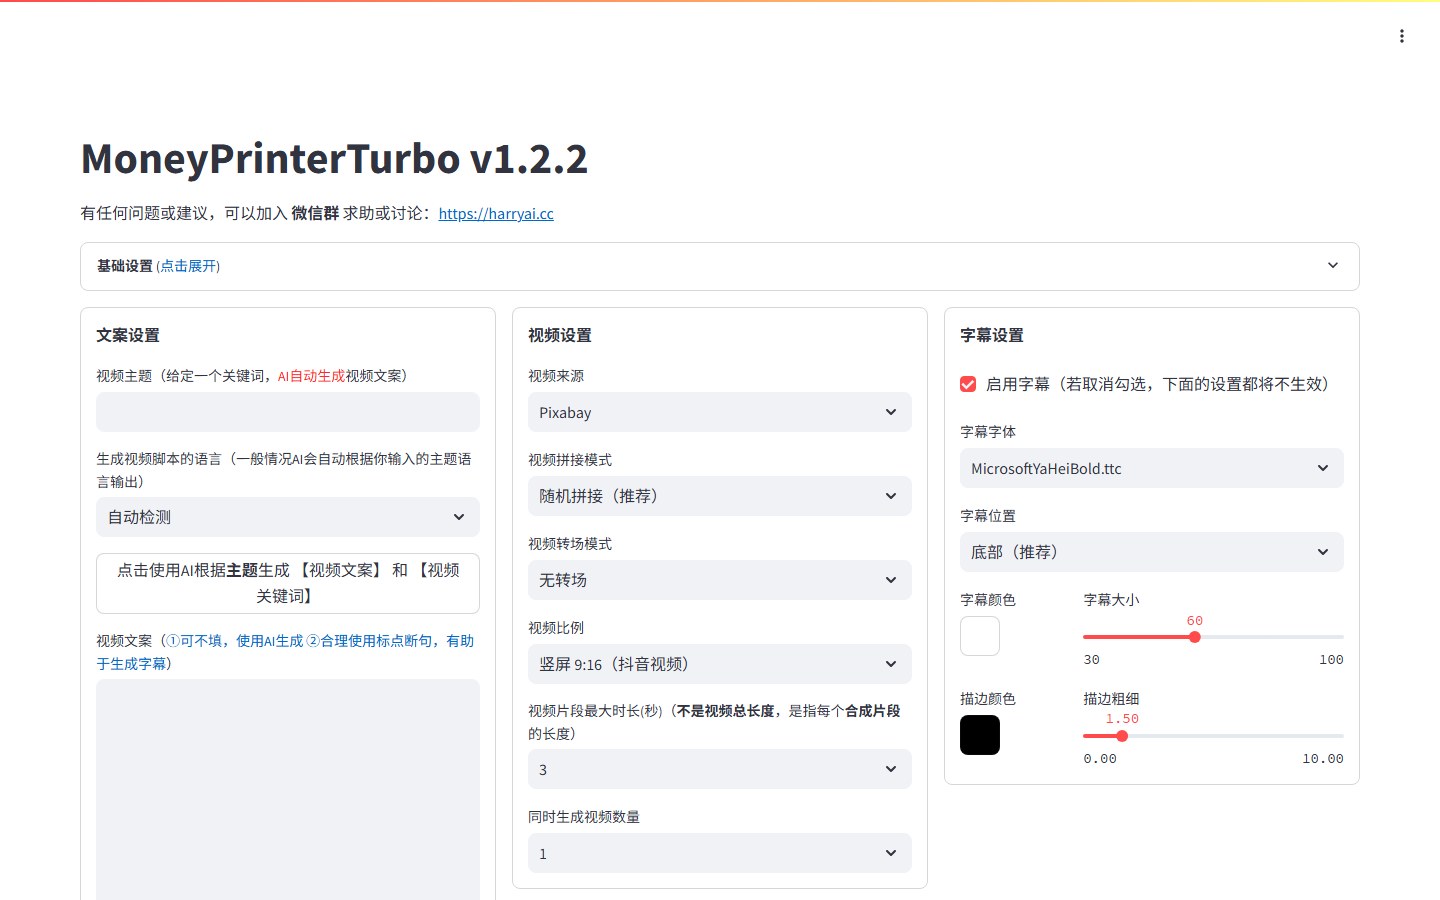
  • 一句话出片:给一个主题,自动生成口播文案与检索关键词,再从素材库找视频、拼接、配音、加字幕、合成竖屏成片。
  • 可控:视频来源、拼接模式、转场、画面比例、单段时长、并发条数;字幕的字体、位置、颜色、字号、描边都能调。
  • 本地语音:中文配音走本地 VITS 模型,不依赖外部 TTS 接口,也不按次计费。

迁移踩的坑

1. 路径全是写死的。配置里是 E:/workbuddy/... 和 C:/.../ffmpeg.exe。上传时按映射表统一替换成服务器路径,模型、素材目录、ffmpeg 一次到位,避免改一处漏一处。

2. 依赖装不上。语音识别用的 sherpa-onnx 在清华源里没有,换阿里云源才装上;faster-whisper 还要和 ctranslate2、onnxruntime 的版本对齐。

3. 上传脚本把自己的代码删了。脚本里按目录名全局跳过 models(本意是跳过 170M 的模型),结果把 app/models 这个 Python 包一起跳了,线上直接 ModuleNotFoundError,页面 200 但内容是一段报错栈。改成只跳过仓库根级目录才对。这个坑很典型:排除规则的作用域,比规则本身更容易出错。

4. Streamlit 的 WebSocket。它不是普通 HTTP,反代必须带 Upgrade / Connection 头,否则页面能打开但一直转圈;出片动辄几分钟,读超时也从默认 60 秒拉到 3600 秒。

5. 内存。ffmpeg 合成加语音识别是内存大户,小机器不加 swap 会被 OOM 直接杀掉,而报错看起来像「视频生成失败」,很容易查错方向。

结果

已上线 autoclip.gaofengtech.cn,浏览器打开就能用,不用装环境。代码与资源分离管理:代码走私有仓库,170M 模型和字体按需上传,配置里的密钥只在服务器侧存在。

autoclip 短视频自动生成平台界面
nginx-proxy.conf
# Streamlit 走 WebSocket,必须转协议头 location ^~ / { proxy_pass http://127.0.0.1:8501; proxy_http_version 1.1; proxy_set_header Upgrade $http_upgrade; proxy_set_header Connection "upgrade"; # 出片要几分钟,超时拉长 proxy_read_timeout 3600s; proxy_buffering off; }

这些项目塑造了我的工程习惯

不是每一个都值得展开写,但它们让我习惯了「业务复杂、数据要对、现场要能用」。

西部农林牧交易中心

交易、资金、溯源、冷链、OA、BI、IOT;项目经理兼架构,带 10 人以上团队,从组建到上线运营。

智慧农贸市场管理平台

统一支付、电子结算、资金管理、商户管理;J2EE / Spring MVC / Hibernate / Axis2 / Nginx。

集团牧业平台 / 国家育种平台

SSH + Oracle;服务全国畜牧总站、北京种畜禽遗传资源中心、伊利、蒙牛、卫岗、新希望、圣牧。

智慧交通 / 土地交易 / 茶交所

现场实施、客户对接、验收;做过小组主管,也做过一线开发。

想看更细的?

简历里有完整的时间线和技术栈。也可以直接发邮件,我把项目文档、代码结构或演示发给你。